文章目录
评测摘要与实验溯源
- 评测对象:开源全模态音视频生成基座
MiniMaxAI/MiniMax-H3(31B–33B)及其轻量化自蒸馏衍生模型VideoRebirthAI/hyperflow-h3-flash(13.7B / 13.9BW8A8 INT8 convrot&GGUF),横向对照海螺官方商业云 API。- 实测算力集群:3 × NVIDIA RTX PRO 6000 Blackwell Server Edition(Google Colab G4 实例,单卡
94.97 GiB可用 GDDR7 显存)+ 3 × NVIDIA A100-SXM4-80GB(Colab High-RAM 实例,单卡80 GiBHBM2e +167 GB系统内存),总计 522 GiB 并发显存。- 实验样本规模:11 组受控基准消融实验(
E01–E11,CUDA 事件级分阶段同步计时 + 10ms 驱动层峰值显存轮询)+ 52 镜次15.08s(362帧)电影级复杂运镜长镜头生产日志,最终完成 10 分 22.3 秒(40 镜)院线级有声短片《子午线回响》(Echoes of the Meridian) 精剪母带交付。- 统一输出基线:原生
1344 × 768(768p)、24 fps视频 +32 kHz双声道立体声同步直出(后期母带经 EBU R128-16 LUFS响度标准化封装)。
一、 核心评测结论速览(Executive Summary)
- 综合吞吐、画质与成本冠军路线:
Colab G4(RTX PRO 6000 Blackwell 96 GB)+
HyperFlow H3 Flash(W8A8 INT8 convrot)+FP8文本编码器(DeepGEMM)+offload="none"(全显存常驻)。- 在
362帧(15.08s)长镜头生成任务中,G4 端到端实测速度比同平台 A100-SXM4-80GB 快1.89×–2.14×(如fl2va6 步续接:361.0svs772.3s),而单小时算力配额消耗(~8.8 CU/h)不到 H100(18.05 CU/h)的一半,且避开了 H100 高峰期频发的库存售罄问题。
- 在
- 解锁单卡 15 秒全显存常驻的决定性开关:
将自动裁剪至前 50 层的
Qwen3-VL-32B文本编码器从BF16切换为FP8,在固定随机种子下成片构图、光影与音轨高度一致,却直接净省22.65 GiB分配显存,使362帧长序列峰值显存稳压在63.44–81.14 GiB;若保留BF16 + offload="none",15 秒序列将突破~99.7 GiB直接导致 96 GB 显卡 OOM 崩溃。 - 24 GB 消费级显卡的“零画质妥协”路径:
开启
offload="stream"(主机锁页内存流式异步卸载) 可将驱动层峰值显存从57.82 GiB断崖式压降至15.08 GiB(降幅-73.9%)。因算子数值精度完全不变,其成片画质与立体声音轨与全显存常驻模式 100% 数学等价,端到端耗时仅增加+11.7%(77.34s → 86.39s),显著优于有损且丧失音视频参考能力的GGUF Q4量化(前提为主机配备≥ 69 GiB物理内存)。 - 采样步数与长镜头时长的工程黄金律:
- 步数分层策略(仅限校准网格
[4, 6, 8]步):6步是批量主摄黄金甜点(比 4 步全局锐度提升+33.2%,比 8 步省时22%–23%,在 40 镜实战中首轮一次达标率达 75%);8步是复杂物理遮挡与多主体一致性精修档(彻底治愈对称石门双人幻觉、遮挡后结构消失与跨镜头衣色漂移,使剩余 25% 疑难镜头重拍后 100% 达标)。 - 突破 15 秒上限的 30 秒一镜到底架构:受 3D 全注意力
O(N²)复杂度支配,从5.17s(124f)拉长至15.08s(362f)时长仅增2.92×,单步去噪耗时却暴涨6.34×(8.44s → 53.52s)。构建 30 秒连续长镜头 的最优解法是**“首镜ref2va(锁死角色与环境锚点)+ 次镜fl2va(提取首镜末帧无缝续接,单步比双锚ref2va快35.8%)”**。
- 步数分层策略(仅限校准网格
二、 模型底层改造机制与五大部署路线全景定位
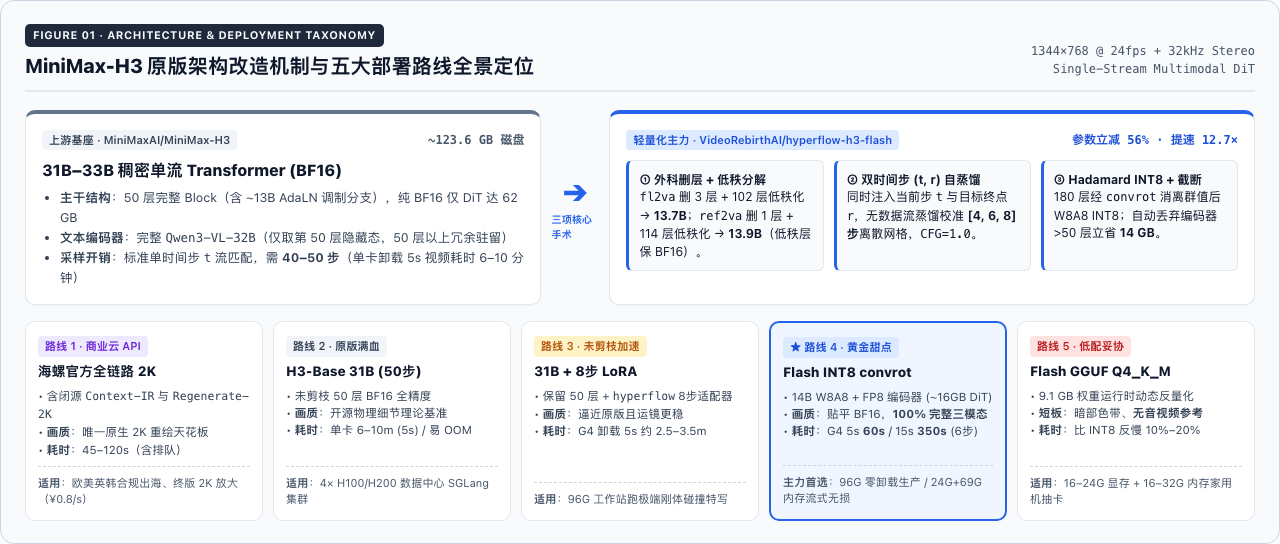
HyperFlow H3 Flash 并非简单的训练后量化(PTQ)或外挂加速 LoRA,而是针对原版 MiniMax-H3(50 层稠密单流音视频联合扩散架构)实施了三项协同的底层结构手术:
- 外科式结构剪枝 + BF16 低秩矩阵分解(Block Pruning & Low-Rank Factorization)
fl2va分支(负责文生音视频t2va与首尾帧续接):移除贡献度最低的 3 个 Transformer Block(第 6、21、22 层),并将 102 个线性层分解为保留BF16精度的低秩矩阵,参数量从 ~31B 降至13.7B。ref2va分支(负责多模态参考注入):仅移除 1 个 Block(第 9 层)以保全跨模态参考路由能力,将 114 个线性层低秩化,参数量降至13.9B。
- 双时间步
(t, r)条件流自蒸馏(Two-Time Flow Self-Distillation)- 原版每步仅输入当前噪声水平
t,需40–50步带 CFG 采样;Flash 版重写时间嵌入层,使每个 Token 同时接收当前时间步t与当前步积分终点r(endpoint_timestep),实现CFG = 1.0(零负面提示词开销)下在离散校准网格[4, 6, 8]步内高速收敛。
- 原版每步仅输入当前噪声水平
- 块对角 Hadamard 正交旋转量化(
convrotW8A8 INT8)与编码器无损截断- 对主干 180 个核心线性层先施加块对角 Hadamard 正交旋转,抹平激活值通道离群峰(Outliers)后再执行 W8A8 INT8 矩阵乘,最大限度保留了暗部微反差与
32 kHz立体声高频瞬态。 - 同时利用原版仅提取
Qwen3-VL-32B第 50 层隐藏状态的特性,Python 加载器自动丢弃第 50 层之上的冗余网络层,零精度损失立省约14 GB显存/内存。
- 对主干 180 个核心线性层先施加块对角 Hadamard 正交旋转,抹平激活值通道离群峰(Outliers)后再执行 W8A8 INT8 矩阵乘,最大限度保留了暗部微反差与
五大部署路线横向对比矩阵
| 部署路线 | 权重结构与精度 | 输出上限 & 原生时长 | 多模态能力完整性 | 视觉画质与立体声表现 | 推理时长量级与适用边界 |
|---|---|---|---|---|---|
| 1. 海螺商业云 API ( H3 + Context-IR + Regenerate-2K) |
31B–33B 云端全链路 + 二阶段 2K 重生成模块 | 原生 768p / 2K 4–15s |
完整 t2va / fl2va / ref2va(图+视+音) |
全路线最高天花板:唯一具备官方原生 2K 细节重绘路径,中英文字形最准 | 约 45–120s(含排队);768p 约 $0.08/s,2K 约 ¥0.80/s;无欧美英韩许可证限制 |
2. 开源原版 MiniMax-H3(~31B–33B BF16,40–50 步) |
50 层未剪枝稠密 DiT + 全量 BF16 编码器(总磁盘 ~123.6 GB) | 原生 768p 5.2–15.1s |
完整三模态 | 开放权重理论基准:极端复杂多刚体物理碰撞容量最足,但未蒸馏采样极慢 | 面向 4× H100/H200 集群;单卡卸载 5s 需 6–10 分钟,80 GB 显存易在 VAE 阶段 OOM |
| 3. 未剪枝少步加速路线 ( MiniMax-H3 31B + hyperflow 8步 LoRA / Comfy-Org AdaLN 预计算版) |
保留全部 50 层主干 + 8步流蒸馏适配器(或折叠推理恒定的 13B AdaLN) | 原生 768p 5.2–15.1s |
完整三模态 | 复杂物理交互贴近原版 50 步,同种子运镜稳定性甚至优于默认长步数 | 单卡 96 GB G4 需开 auto_cpu_offload,5.2s 约 150–210s,15s 约 12–16 分钟;受限于 >125 GB 磁盘空间 |
| 4. 剪枝蒸馏主力路线(★推荐) ( hyperflow-h3-flash W8A8 INT8 convrot) |
13.7B/13.9B W8A8 INT8 + BF16 低秩层 + 50层裁剪编码器 | 原生 768p 5.2–15.1s |
100% 完整(支持最多 9图+3视频+3音频参考) | 高度贴平 BF16 的实用甜点:配 Context-IR 剧本提示词,6–8步光影、长运镜与立体声拟音俱佳 |
单卡 G4 稳态:5.2s 仅 43–77s,15.1s 长镜头 350–457s;4× B200 可达 768p 实时生成 |
| 5. 消费级低比特妥协路线 ( hyperflow-h3-flash GGUF Q4_K_M / Q3_K_M) |
7.2–9.1 GB 非对称块量化,运行时动态反量化 | 原生 768p 5.2–15.1s |
受限:ref2va 仅支持图片参考,不支持视频/音频参考 |
暗部阴影易现色阶断层、水面高频反光涂抹,小字号汉字易粘连 | 面向 16–24 GB 显存 + 16–32 GB 内存家用主机;在 ≥24 GB 显卡上反比 INT8 convrot 慢 10%–20% |
三、 硬件算力与显存驻留路线实测剖析
1. 端到端推理耗时全景与跨架构对比(G4 Blackwell vs A100-SXM4)
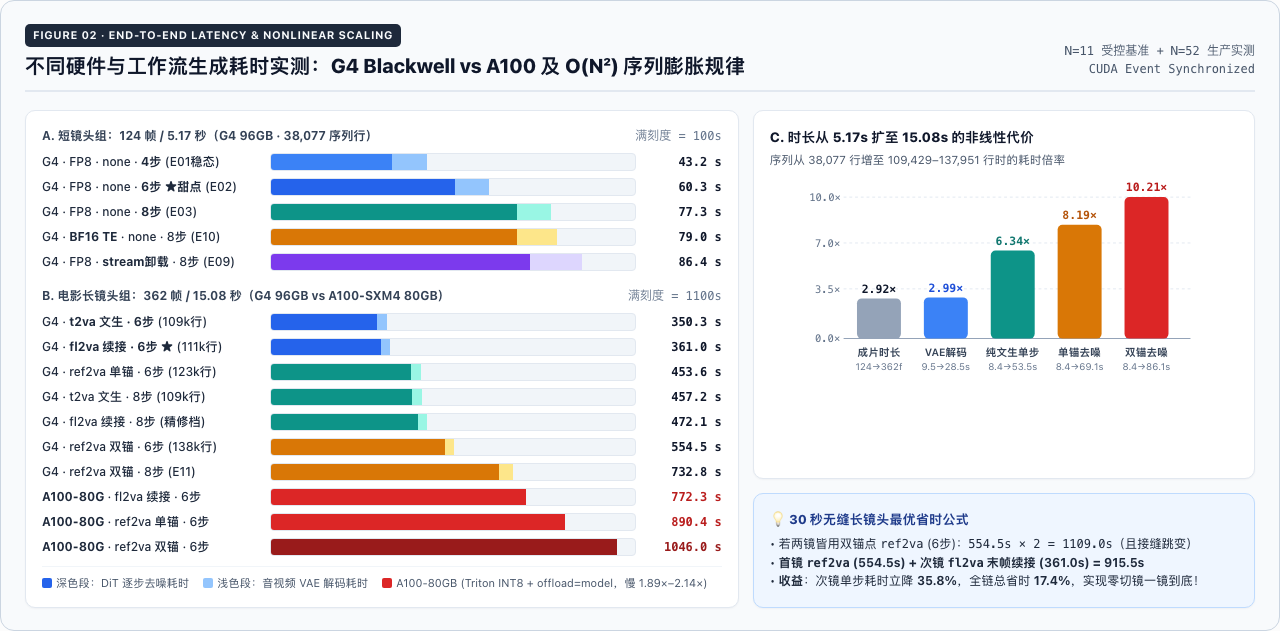
我们在基准测试引擎中通过 CUDA 同步钩子精确剥离了 文本编码(text_encoder)、参考图编码(vae_encoder)、逐步 DiT 去噪(denoise) 与 音视频双 VAE 解码(vae_video / vae_audio) 的真实耗时,11 组受控基准全量数据如下:
| 实验编号 | 工作流 & 部署配置 | 步数 | 帧数 / 成片时长 | 潜空间序列行数 | 实测总耗时 (稳态净耗时) | 单步去噪均值 | 视频 VAE 解码 | 驱动峰值显存 | 主机峰值 RSS | 拉普拉斯锐度 (均值 / 最低帧) | 帧间运动 MAD | 音频响度 RMS / 立体声宽度 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
E01 |
t2va · fp8 TE · none |
4 | 124f / 5.17s |
38,077 | 64.73s *(43.15s)*¹ | 8.356s | 9.56s | 57.82 GiB | 48.40 GiB | 54.35 / 29.46 | 12.23 | -20.81 dBFS / 0.34 |
E02 |
t2va · fp8 TE · none |
6 | 124f / 5.17s |
38,077 | 60.26s | 8.409s | 9.52s | 57.82 GiB | 48.40 GiB | 72.38 / 37.92 | 14.44 | -19.52 dBFS / 0.22 |
E03 |
t2va · fp8 TE · none |
8 | 124f / 5.17s |
38,077 | 77.34s | 8.436s | 9.54s | 57.82 GiB | 48.40 GiB | 59.08 / 30.22 | 14.42 | -20.77 dBFS / 0.28 |
E09 |
t2va · fp8 TE · stream |
8 | 124f / 5.17s |
38,077 | 86.39s (+11.7%) | 8.910s | 14.20s | 15.08 GiB | 66.55 GiB | 59.46 / 30.71 | 14.42 | -20.77 dBFS / 0.28 |
E10 |
t2va · bf16 TE · none |
8 | 124f / 5.17s |
38,077 | 79.00s (+2.1%) | 8.456s | 10.94s | 76.37 GiB | 25.55 GiB | 63.09 / 34.79 | 15.02 | -20.40 dBFS / 0.26 |
E04 |
t2va · fp8 TE · none |
6 | 362f / 15.08s |
109,429 | 350.27s (5.84m) | 53.515s | 28.66s | 81.14 GiB | 48.40 GiB | 149.50 / 47.49 | 8.67 | -23.06 dBFS / 0.37 |
E05 |
t2va · fp8 TE · none |
8 | 362f / 15.08s |
109,429 | 457.24s (7.62m) | 53.518s | 28.52s | 81.14 GiB | 48.40 GiB | 103.03 / 59.71 | 9.22 | -22.44 dBFS / 0.17 |
E06 |
t2va · fp8 TE · none (P2) |
8 | 362f / 15.08s |
109,410 | 479.43s *(457.84s)*¹ | 53.614s | 28.68s | 63.44 GiB | 48.19 GiB | 14.66² / 4.47 | 5.25 | -27.96 dBFS / 0.19 |
E07 |
t2va · fp8 TE · none (P3) |
8 | 362f / 15.08s |
109,416 | 458.32s (7.64m) | 53.653s | 28.51s | 63.44 GiB | 48.19 GiB | 96.76 / 42.15 | 8.69 | -43.19 dBFS³ / 0.19 |
E08 |
fl2va · 末帧无缝续接 |
8 | 362f / 15.08s |
111,302 | 473.28s (7.89m) | 55.275s | 28.69s | 75.20 GiB | 48.40 GiB | 96.24 / 45.73 | 7.85 | -23.91 dBFS / 0.10 |
E11 |
ref2va · 双锚 · chunk=16k |
8 | 362f / 15.08s |
137,951 | 732.81s (12.21m) | 86.125s | 28.62s | 68.96 GiB | 28.90 GiB | 10.82² (P95=37.4) | 6.04 | -18.00 dBFS / 0.10 |
- 注¹(冷启动 JIT 编译剥离):
E01与E06分别为各自实例首次处理超长三段式提示词,触发DeepGEMMFP8 算子即时编译,使text_encoder产生一次性约21.5s开销;编译缓存就绪后(E02–E05、E07),稳态文本编码仅0.12s,故E01(4 步)真实稳态推理耗时为43.15s(实时倍率8.35×)。音频 VAE 解码在5.17s与15.08s下仅需0.04s与0.10s。- 注²(变形宽银幕浅景深对全图锐度的稀释):
E06(冰川火山脊策马跟拍)与E11(极地悬崖 270° 环绕)采用 35mm 大光圈浅景深构图,大面积背景海雾与阴云呈自然光学虚化,拉低了全画面高频方差均值,但局部焦点区块P95锐度(37.4)与实拍帧均证实前景人物五官与黄铜仪器焦点锐利。因此在电影级自动质检中必须联合考察sharpness_patch_p95。- 注³:
E07音频均值-43.19 dBFS系剧本要求日全食食甚瞬间“钟表停摆、万籁俱寂仅余微弱金属泛音”,体现了极佳的声画语义遵循度。
异构生产集群同台对决:G4 Blackwell (96 GB) vs A100-SXM4 (80 GB) vs H100 (80 GB)
在 40 镜短片并行摄制阶段,3 台 G4(w1–w3,完成 39 镜次) 与 3 台 A100-SXM4-80GB(w4–w6,完成 13 镜次) 同台渲染 362 帧(15.08s)、6 步长镜头,实测对比如下:
长镜头工作流(统一 362 帧 / 15.08s,6 步) |
G4 Blackwell 96GB (sm_120)FP8 TE + offload=none + cuBLAS INT8 |
A100-SXM4 80GB (sm_80)BF16 TE + offload=model + Triton INT8 |
G4 相对 A100 加速比 | 跨架构成片质量一致性 |
|---|---|---|---|---|
fl2va 尾帧无缝续接(111.3k 行) |
中位 361.0s(6.02 分钟,~55.3s/step) |
均值 772.3s(12.87 分钟,~121s/step) |
2.14× | 完全一致:A100 产出的 S32、S38 焦点锐度 P95 达 269.5–367.1 |
ref2va 单锚点锁定(~123k 行) |
中位 453.6s(7.56 分钟,~69.1s/step) |
均值 890.4s(14.84 分钟,~130.2s/step) |
1.96× | 完全一致:跨卡剪辑零色差、零分辨率折损、零冻帧 |
ref2va 双锚点锁定(138.0k 行) |
中位 554.5s(9.24 分钟,~84.9s/step) |
均值 1046.0s(17.43 分钟,~158.1s/step) |
1.89× | 完全一致:人物护目镜、深青灰风衣与建筑几何严格统一 |
- 底层硬件归因:
A100(Amperesm_80)缺乏原生fp8e4nv指令,无法运行 FP8 编码器与DeepGEMM,必须加载BF16文本编码器并通过offload="model"在编码后换回主机内存;同时其 INT8 线性层只能回退至软件融合的Triton INT8核函数,吞吐远不及 G4 Blackwell(sm_120)原生cuBLAS INT8Tensor Core + 全程零卸载常驻。 - H100 (80 GB) 的定位:H100 凭借
3.35 TB/sHBM3 带宽与独占FlashAttention-3 (fa3),在显式开启--attention fa3 --text-encoder-precision fp8 --offload model时单条长序列去噪比 G4 快约25%–35%;但因其显存仅79.6 GiB(差一口气无法开启 15soffload="none")、Colab 配额消耗贵 2.05 倍 且极易库存告急,日常主力生产首选 G4,多机极限抢工期则采用3× G4 + 3× A100跨配额池异构并发。
2. 驱动层峰值显存红线与主机内存转移规律
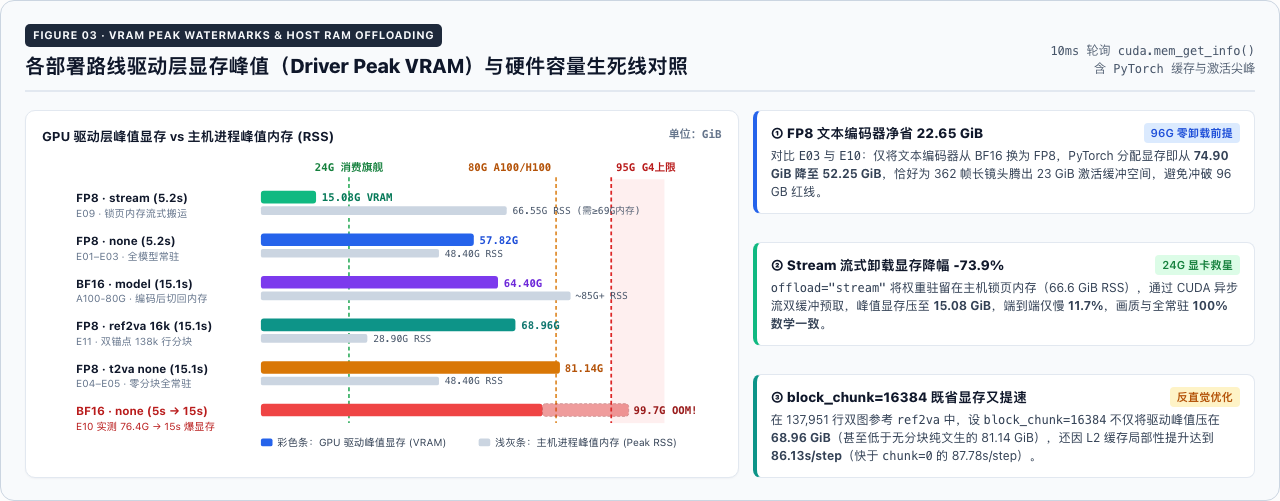
FP8文本编码器是 96 GB 单卡跑通 15 秒零卸载的生死线:对比E03与E10,将文本编码器由BF16切至FP8使 PyTorch 分配显存从74.90 GiB直降至52.25 GiB(净省22.65 GiB),恰好容纳362帧长序列新增的约23.3 GiB激活张量(峰值81.14 GiB < 94.97 GiB)。offload="stream"实现 24 GB 消费卡无损运行:权重常驻于66.55 GiB主机锁页内存(Pinned RAM),通过 CUDA 异步流预取掩盖了绝大部分 PCIe 传输开销(单步去噪仅从8.436s微增至8.910s,+5.6%),将驱动峰值显存死死压在15.08 GiB。- 反直觉发现:
block_chunk=16384在超长序列下既省显存又提速:在137,951行双锚点ref2va(E11)实测中,block_chunk=16384不仅把驱动层峰值显存控制在68.96 GiB(甚至低于无分块t2va的81.14 GiB),单步去噪还达到86.13s,快于block_chunk=0全序列吞吐的87.78s/step,原因在于分块显著提升了 Blackwell 二级缓存(L2 Cache)命中局部性。
3. 同随机种子实拍对决:FP8 + none vs FP8 + stream vs BF16 + none
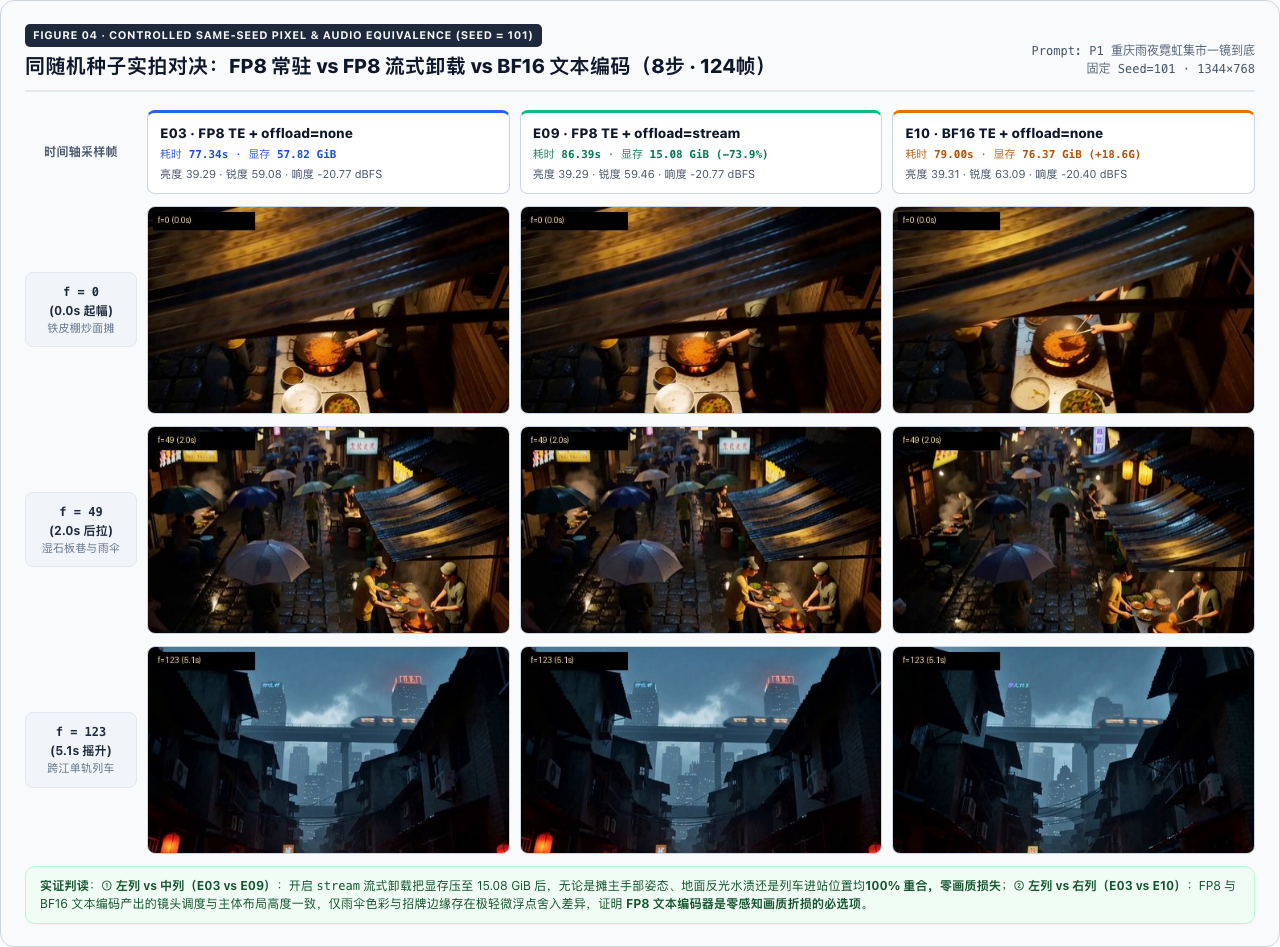
上图截取了固定提示词 P1(重庆雨夜霓虹集市一镜到底)、固定随机种子 Seed = 101、固定 8 步下的三组实验原片采样帧:
E03(左列,FP8 + none,57.82 GiB)vsE09(中列,FP8 + stream,15.08 GiB):从0.0s铁皮雨棚反光纹理、2.0s雨巷透明伞骨架到5.1s单轨列车车头位置 100% 像素级重合,客观亮度(39.29vs39.29)、运动幅度(14.420vs14.422)与立体声响度(-20.77vs-20.77 dBFS)分毫不差。E03(左列,FP8编码器)vsE10(右列,BF16编码器,76.37 GiB):机位轨迹、两位摊主站位与服饰(左黄右绿)、红灯笼透视及列车进桥时刻完全一致(跨视频逐帧平均绝对误差MAE = 22.89 / 255),仅打伞路人局部伞面色相存在微弱浮点舍入级偏移,实证FP8文本编码器在肉眼观感上零画质折损。
四、 关键推理参数与工作流对“画质细节”及“生成时长”的影响机制
1. 离散采样步数消融:4 步 vs 6 步 vs 8 步
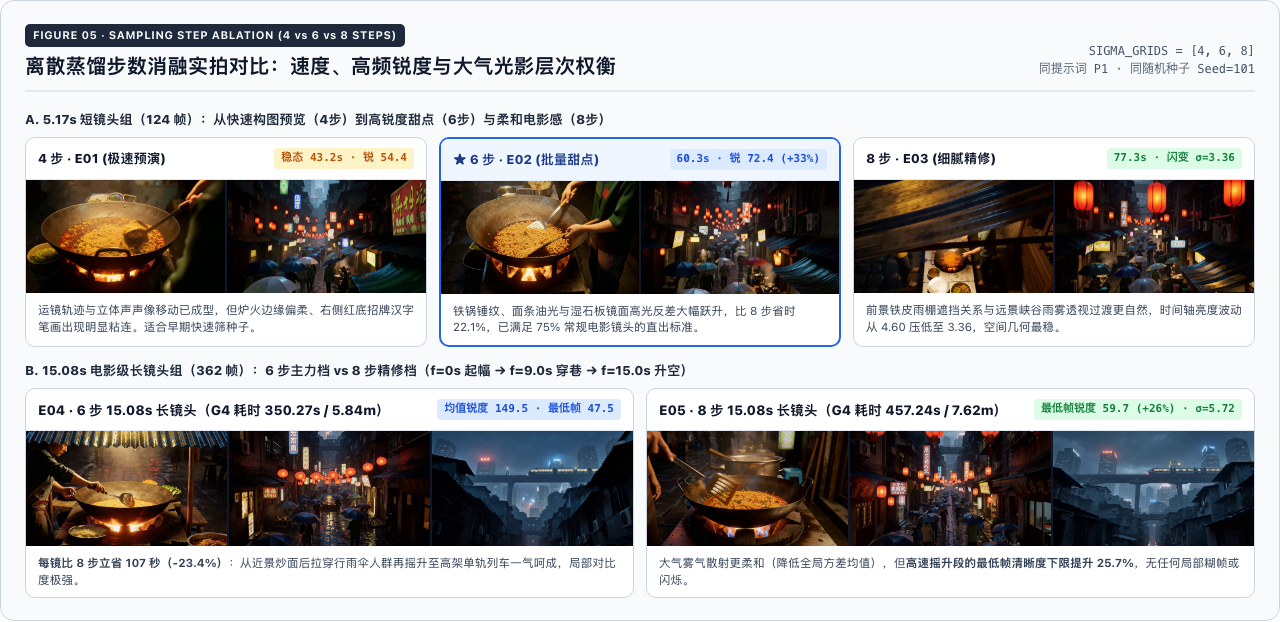
由于 HyperFlow H3 Flash 的时间步调度表 SIGMA_GRIDS 严格针对 [4, 6, 8] 三个离散档位做了自蒸馏校准(不支持传入未校准的中间步数),三档表现呈现出清晰的梯度分工:
4步(极速构图预演档,5.17s稳态仅43.2s):机位推拉摇移与立体声声像移动已准确成型,但高频细节尚未完全收敛——拉普拉斯锐度仅54.35,热油翻炒颗粒偏软,右侧红底招牌汉字笔画粘连(见图 5 左上E01),仅建议用于早期快速筛种子与试构图。6步(主力生产黄金甜点档,5.17s耗时60.3s/15.08s耗时350.3s):相比 4 步,全局锐度跃升+33.2%(54.35 → 72.38,15 秒长镜头E04更是高达149.50),铁锅锤纹、雨滴飞溅与湿石板霓虹倒影对比鲜明;相比 8 步,每条 15 秒长镜头节省107 秒(-23.4%)。在短片 40 个复杂长镜头中,30 个镜头(75%)在 6 步下一次成片即通过严苛导演质检。8步(高难遮挡与空间一致性精修档,5.17s耗时77.3s/15.08s耗时457.2s–732.8s):更细密的(t, r)流轨迹积分使远景雨雾散射与景深过渡更柔和自然(虽拉低了全图高频方差均值,但将 15 秒长镜头的全片最低帧锐度下限从47.49提升至59.71(+25.7%),并将时间轴亮度闪烁标准差σ从8.06压低至5.72)。
2. 短片实战导演质检实录:6 步首轮三大典型瑕疵与 8 步精修治愈机制
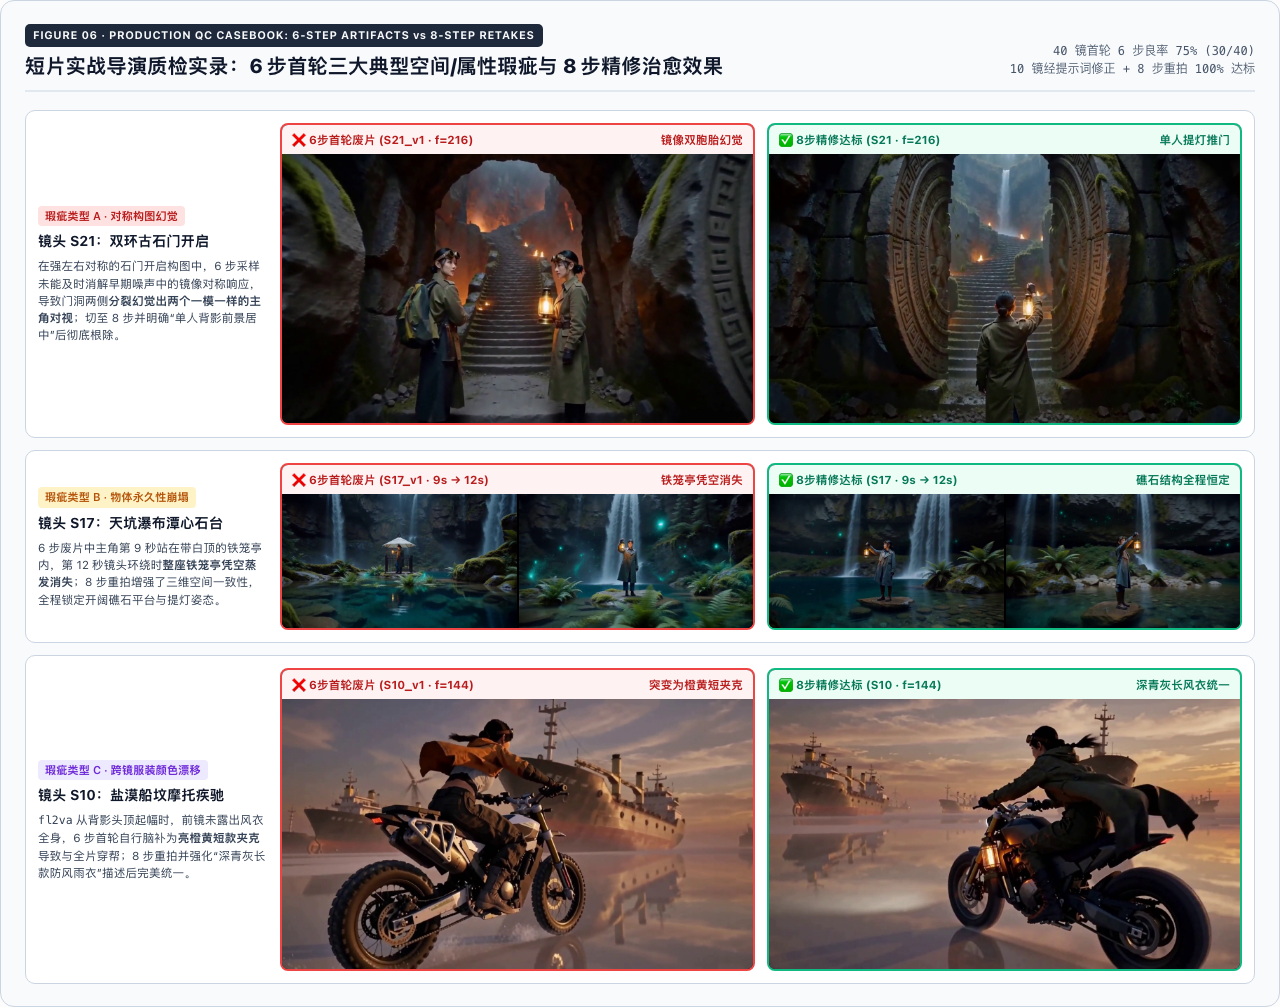
在摄制 10 分钟叙事短片时,我们建立了一套“客观指标自动拦截 + 导演逐镜回放严审”机制,精准捕捉到 6 步在约 25% 极端复杂镜头中的三类边界失效模式,并通过 提示词约束强化 + 8 步精修重拍 实现了 100% 治愈(见图 6 真实废片与重拍帧对照):
- 强对称构图下的“双胞胎镜像幻觉”(如
S21双环石门):当背景呈现严格左右对称的几何结构时,6 步采样偶发未能及时打破早期高斯噪声中的左右对称激活,导致石门开启瞬间门洞两侧分裂出两个相同的女主人公面对面站立;切至 8 步并在提示词中明确锚定前景单人背影轴线后彻底消除。 - 三维空间物体永久性(Object Permanence)中途崩塌(如
S17瀑布潭心):6 步废片中主角第 9 秒站在带白顶的铁笼亭内,第 12 秒环绕运镜经过水雾遮挡后整座铁笼亭凭空蒸发;8 步更密集的跨帧注意力交互显著增强了长时程三维几何记忆,全程保持开阔礁石平台结构恒定。 - 首帧局部遮挡引发的跨镜服饰属性漂移(如
S10盐漠摩托、S22、S26):当fl2va承接的前一镜末帧仅露出人物头部或极远景剪影时,6 步易自行脑补出高饱和度橙黄短夹克或浅白外套;通过补充视觉圣经标准色描述(深青灰长款油蜡防风雨衣)并升级至 8 步重拍,跨镜头人物造型实现严丝合缝的统一。
3. 突破单次 15 秒上限:30 秒无缝长镜头焊接(ref2va → fl2va)与多锚点融合
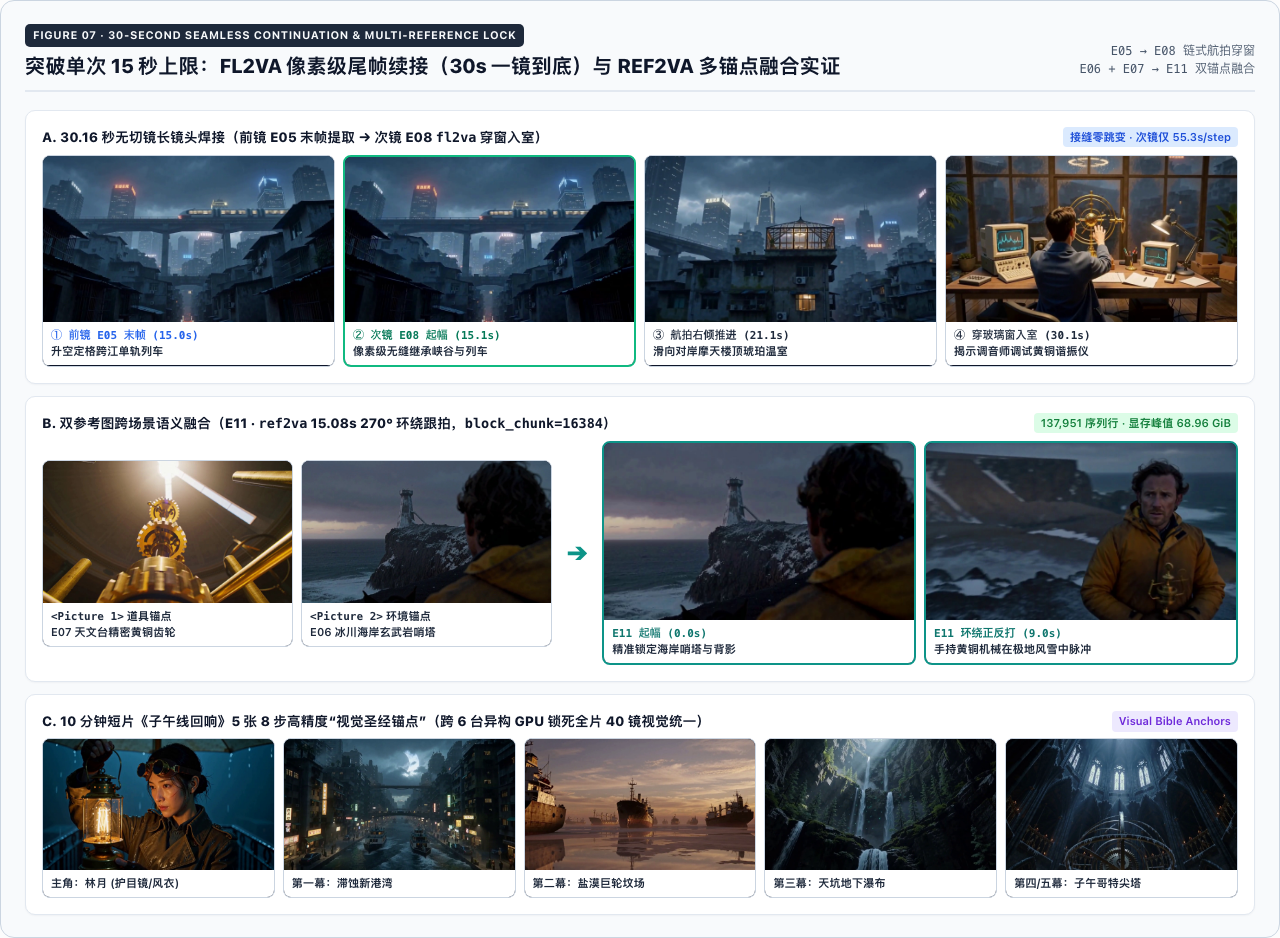
- 非线性算力墙:从
124帧(5.17s)增至362帧(15.08s),成片时长扩大2.92×,视频 VAE 解码呈线性增长(9.54s → 28.52s,2.99×),但 DiT 单步去噪因 3D 全注意力O(N²)复杂度从8.44s激增至53.52s(6.34×);若再叠加两张高清参考锚点图(序列膨胀至137,951行),单步去噪进一步升至86.13s(10.21×)。 - 30 秒一镜到底工业级管线:如图 7A 所示,先由首镜(
ref2va或t2va)生成前15.08s并锁死角色与环境锚点(图 7C 展示的全片 5 张 8 步视觉圣经锚点),随后提取首镜第361帧原图送入次镜fl2va(序列仅111,302行,单步仅55.28s,比双锚ref2va快35.8%),最后在后期母带管线中剔除接缝重复帧、施加 16 帧余弦衰减 RGB 曝光/色温平滑匹配 与 380ms 等功率正余弦立体声交叉淡化,即可产出零切镜感、零音量凹陷的 30 秒真·一镜到底长镜头。
4. 零算力画质倍增器:H3-Context-IR 三段式剧本提示词规范
实验证明,MiniMax-H3 对提示词结构极度敏感。无论使用何种显卡或步数,按训练分布构造三段式结构化提示词——
integrated_multimodal_description:(按[Shot 1]、At 00:04.000、At 00:09.500写明精确时间戳下的景别演进、运镜轨迹、服饰材质与受光反馈);overall_soundscape:(近景动作触发的同步拟音 + 空间立体声声像移动,如单轨列车从左至右的多普勒轰鸣);non_diegetic_music:(配器编制、节奏脉冲与情绪收束)—— 可在 零额外推理耗时 下将运镜完成度与32 kHz立体声纯净度拉升一个量级。
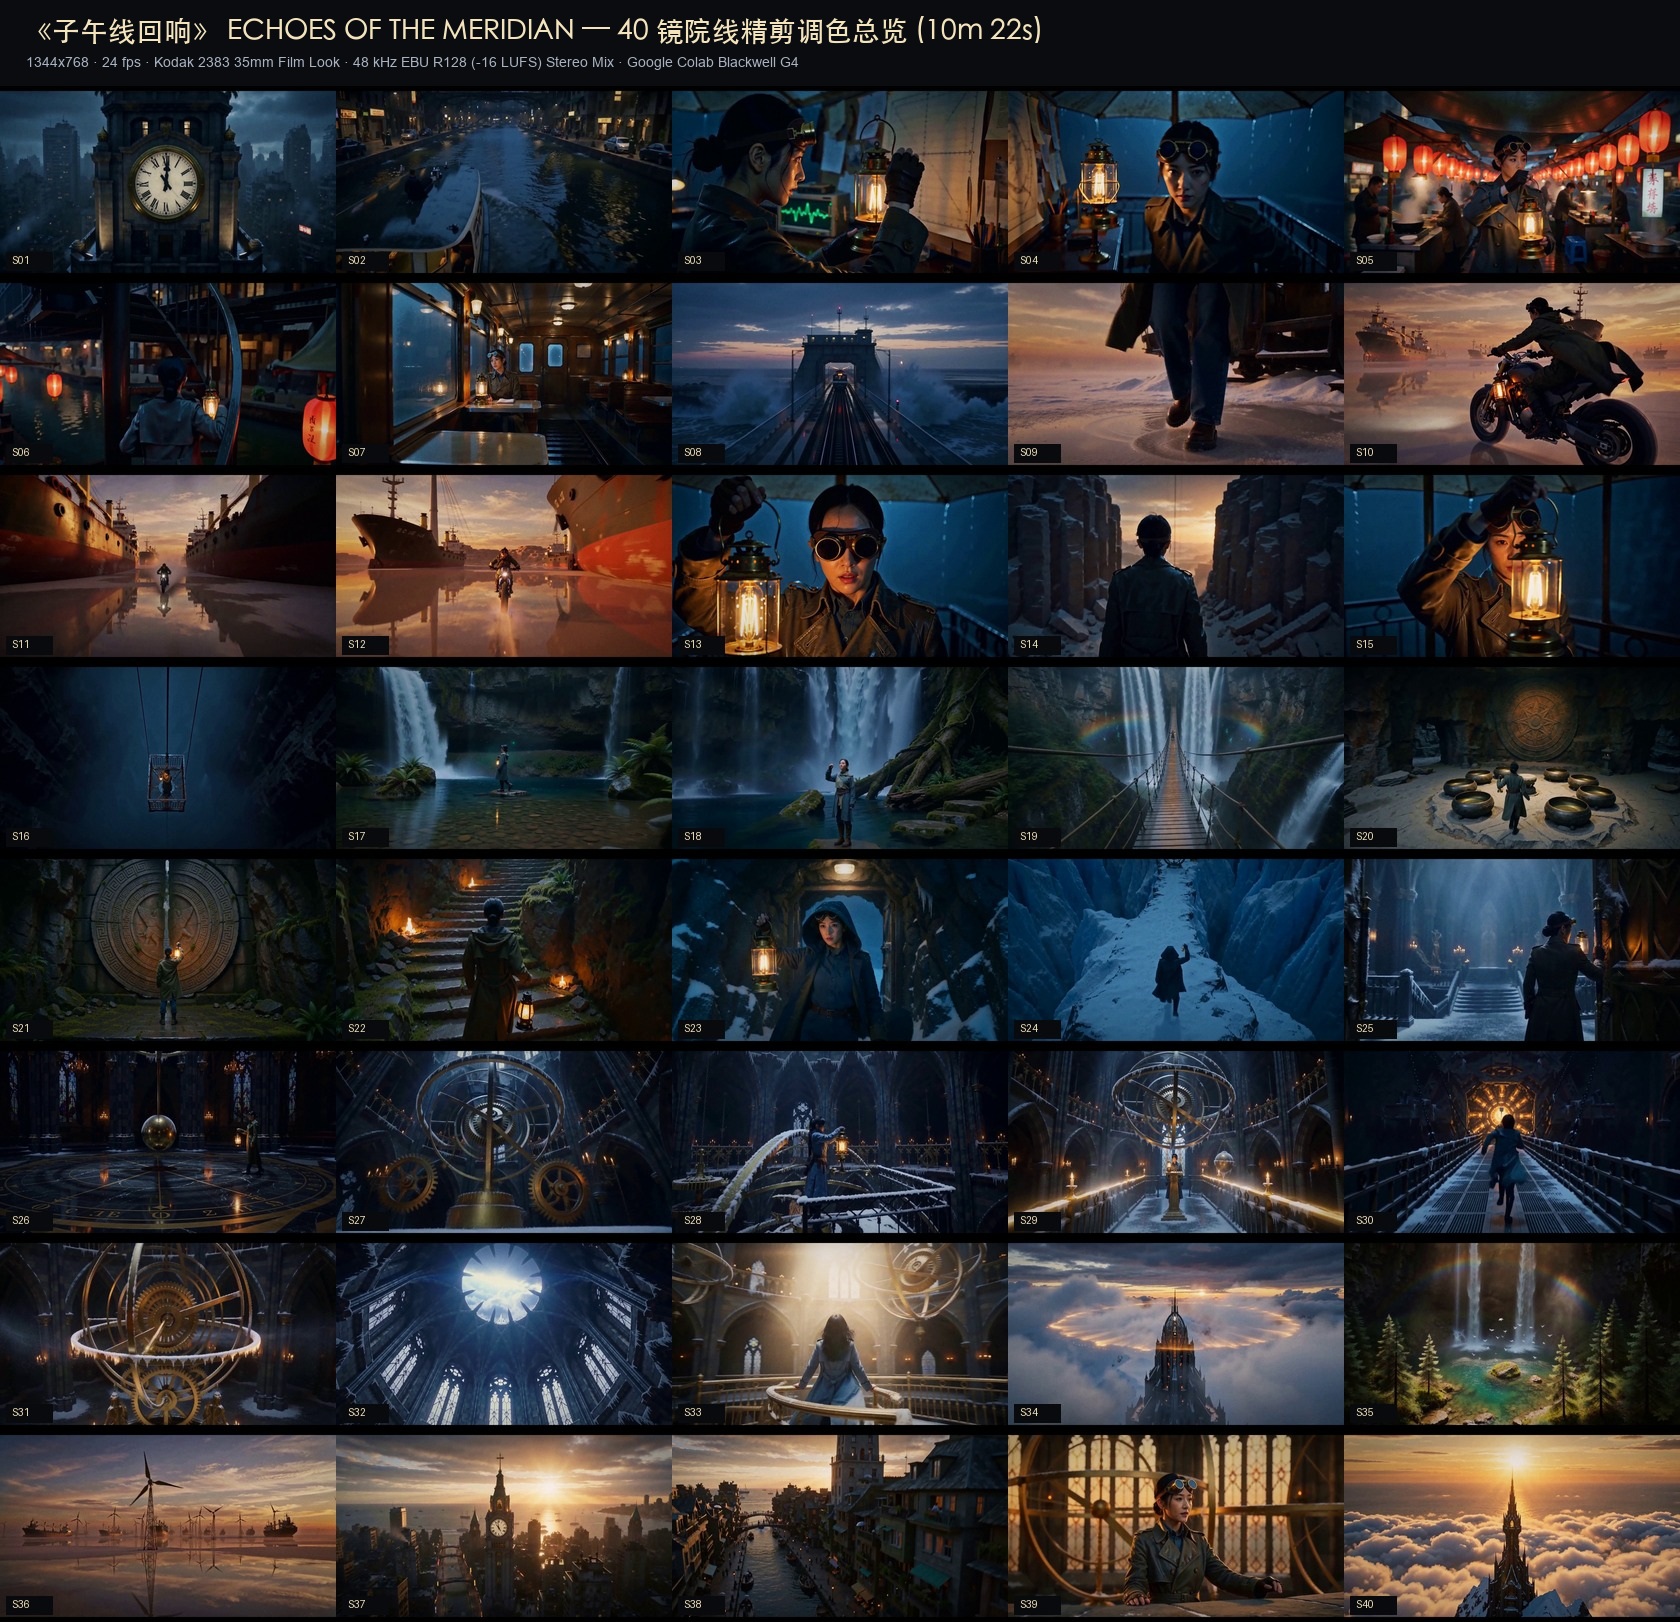
五、 全流程综合实战验证:10 分 22 秒院线短片《子午线回响》生产架构与总览
基于上述评测锁定的黄金参数,我们在 3× G4 + 3× A100 异构集群上高效完成了五幕共 40 个 15.08 秒长镜头(20 条 30 秒连续镜头链) 的并行摄制、35mm Kodak 2383 风格胶片调色、光学晕影颗粒渲染与 48 kHz 多轨混音合成:

六、 分业务与硬件场景最终部署选型指南
| 业务目标与可用硬件 | 推荐最优部署路线与启动参数 | 预期推理耗时与质量水位 |
|---|---|---|
| 云端工作室 / 长短片与连续剧量产 (Colab Pro+ G4 或 96GB 工作站) |
主力首选 G4 Blackwell 96GB(抢工期并挂 A100-80GB):hyperflow-h3-flash Python INT8 + --text-encoder-precision fp8 --fp8-gemm deepgemm --offload none --block-chunk 16384;采用 8步产锚点 + 6步 ref2va→fl2va 跑主摄 + 25% 疑难镜 8步重拍(后台任务配 5 分钟定时心跳防回收) |
5.2s:60.3s;15.1s:5.8–9.2 分钟;30s 双镜链:~15.3 分钟;原生 768p 立体声院线级短片质感 |
| 单条极限低延迟 / Hopper 集群 (H100 / H200 80GB) |
hyperflow-h3-flash INT8 + 显式开启 --attention fa3 --text-encoder-precision fp8 --fp8-gemm deepgemm --offload model(切勿使用默认 bf16 + sdpa) |
5.2s 8步:~35–45s;15.1s:~4–6 分钟;画质同上,单秒算力配额成本较高 |
| 个人高配工作站(追求无损画质) (RTX 3090/4090/5090 24–32G + ≥69G 内存) |
日常文生/图生用 ComfyUI int8_convrot 单文件权重 + fp8/nvfp4 编码器;需多模态音视频参考时用 Python 包 --text-encoder-precision fp8 --offload stream |
5.2s 8步:~83–95s(驱动峰值显存仅 15.08 GiB);100% 无损 INT8 画质与完整三模态 |
| 主流消费级主机(低内存轻量抽卡) (16–24G 显存 + 16–32G 内存) |
ComfyUI-GGUF / stable-diffusion.cpp(打 two-time 补丁)加载 Q4_K_M (9.1 GB) + --fast-disk |
5.2s 6步:~100–140s;仅支持图片参考,暗部与微文字略软,适合低成本构图预演 |
| 商业 2K/4K 超清交付 & 欧美合规出海 | 超清放大:本地 HyperFlow H3 Flash 低成本完成抽卡、复杂运镜与 32 kHz 立体声音轨锁定 → 仅将入选成片送入商业 H3-Regenerate-2K API(或本地串联 LTX-2.5 低重绘幅度 0.25–0.35 超分后回贴原音轨);法务红线: MiniMax H3 Community License 在中国内地、日本、东南亚等地年营收 < \$20M 可免费商用(需显著署名),但明确排除美/欧/英/韩商业自建,面向上述法域请直接调用商业云 API 或选用 Apache-2.0 / MIT 开源底座 |
本地试错边际成本降至纯商业 API 的 1/5–1/10,最终交付兼具顶级动作叙事与 2K/4K 商业清晰度 |